Revisar un artículo sin reescribirlo: IA con Microsoft Foundry
Este artículo forma parte del pilar IA empresarial y sistemas de agentes.
Un borrador puede estar bien escrito y contar algo que yo nunca dije. Puede explicar correctamente una tecnología y exagerar los resultados del ejemplo. O puede desarrollar una buena idea durante varias páginas sin responder la pregunta que abrió al principio.
Para revisar eso necesitamos interpretar el texto. Pero la aplicación que organiza el proceso editorial tiene una necesidad más concreta: decidir si una versión puede continuar, necesita correcciones o debe volver al autor.
Ahí es donde me interesa Microsoft-Decision-1, el modelo de decisión disponible en Microsoft Foundry. Permite pedir juicios acotados que el software puede combinar, sin convertir cada comprobación en otra página de observaciones generadas.
Voy a llevarlo al problema de revisar los artículos de este blog. El ejemplo adapta ese flujo editorial a Microsoft-Decision-1; las solicitudes y respuestas que aparecen son ilustrativas, no el resultado de una integración ejecutada. La idea es entender qué haría cada pieza y por qué esta clase de IA puede resultar útil en una aplicación cotidiana.
La pregunta que necesita el programa
Cuando le pedimos a un LLM «revisa este artículo», podemos recibir una respuesta útil, pero amplia: comentarios, recomendaciones, cambios de estilo y quizá una nueva versión del texto. Todo eso tiene sentido si queremos trabajar sobre la redacción.
Para controlar el flujo conviene separar preguntas más pequeñas:
- ¿El borrador respeta la información que proporcionó el autor?
- ¿El ejemplo permite entender la decisión técnica?
- ¿Hay evidencia suficiente para sostener una cifra?
La primera puede terminar en una opción; la segunda, en una puntuación; la tercera, en una señal para detener la revisión y pedir una fuente. El resultado útil está en lo que puede hacer el programa después de recibir esas respuestas.
Según la documentación de Microsoft-Decision-1, la API recibe un state con texto o JSON y preguntas de tres tipos:
| Tipo | Qué permite preguntar | Qué devuelve |
|---|---|---|
noul |
Si se cumple una condición | Una probabilidad entre 0 y 1 |
choice |
Cuál de varias opciones corresponde | Una elección y probabilidades por opción |
score |
Cuánto cumple un criterio | Una puntuación y una distribución por niveles |
El modelo no redacta una justificación libre. Por eso no le pediría que proponga cómo mejorar un párrafo: esa tarea sigue correspondiendo a quien escribe o a un modelo generativo.
Un ejemplo: detectar una promesa que la fuente no sostiene
Supongamos que la información original de un artículo dice:
El proceso sigue en pruebas. Todavía no hemos medido el ahorro.
Pero el borrador termina afirmando:
El sistema ya redujo un 90 % el coste en producción.
La frase puede sonar convincente y estar perfectamente escrita. El problema es que convirtió una prueba sin mediciones en un resultado de producción. Un corrector ortográfico no va a encontrar ese salto.
Para plantearlo con Microsoft-Decision-1, separaría el borrador de su fuente y definiría qué respuestas acepta la aplicación:
{ "model": "evaluador-editorial", "state": { "fuente": "El proceso sigue en pruebas. No hemos medido el ahorro.", "borrador": "El sistema ya redujo un 90 % el coste en producción." }, "questions": { "fidelidad": { "type": "choice", "instructions": "Contrasta el borrador con la fuente del autor.", "criteria": { "fiel": "Conserva los hechos y el alcance de la fuente.", "contradice_fuente": "Cambia hechos o atribuye resultados incompatibles con la fuente.", "informacion_insuficiente": "La fuente no permite comprobar la afirmación." } } }}evaluador-editorial representa el nombre de un deployment en Foundry. La solicitud se envía al endpoint /providers/microsoft/v1/systemone del recurso; no es una llamada a un endpoint de chat.
La parte relevante de una salida ilustrativa podría verse así:
{ "type": "choice", "choice": "contradice_fuente", "probabilities": { "fiel": 0.01, "contradice_fuente": 0.97, "informacion_insuficiente": 0.02 }}Con ese resultado, el programa puede marcar la afirmación para corregirla. Si la información es insuficiente, puede devolverla al autor para que aporte la fuente. Ninguna de esas acciones requiere generar otro artículo.
La opción elegida sirve para dirigir el trabajo; las probabilidades ayudan a decidir cuándo conviene intervenir. Ese 0,97 del ejemplo no es una garantía de acierto. Antes de automatizar habría que comprobar cómo se comporta la pregunta con borradores propios, especialmente en los casos ambiguos.
Evaluar varias cosas sin perder las responsabilidades
Una contradicción evidente es un caso fácil de explicar. La revisión completa tendría preguntas sobre la utilidad del ejemplo, la claridad del argumento y el respaldo de las conclusiones. Cada una necesitaría criterios concretos, porque «¿está bien el artículo?» deja demasiado espacio a la interpretación.
Por ejemplo, para puntuar un caso práctico podríamos distinguir entre mencionar una herramienta, mostrar cómo se utiliza y explicar por qué esa elección resuelve el problema presentado. Una nota alta debería significar algo reconocible para quien revisa el resultado.
Después combinaría las respuestas en código. Una buena puntuación de claridad no debería compensar una contradicción con la fuente. Y si el modelo no tiene información suficiente, la aplicación debería poder dejar el caso pendiente en lugar de forzar una aprobación.
El flujo quedaría así:
- El agente prepara el borrador a partir de la idea y las fuentes.
- Microsoft-Decision-1 evalúa preguntas delimitadas sobre ese material.
- El código aplica la política editorial a las respuestas.
- El agente corrige los defectos identificados y el autor resuelve las dudas que requieren su criterio.
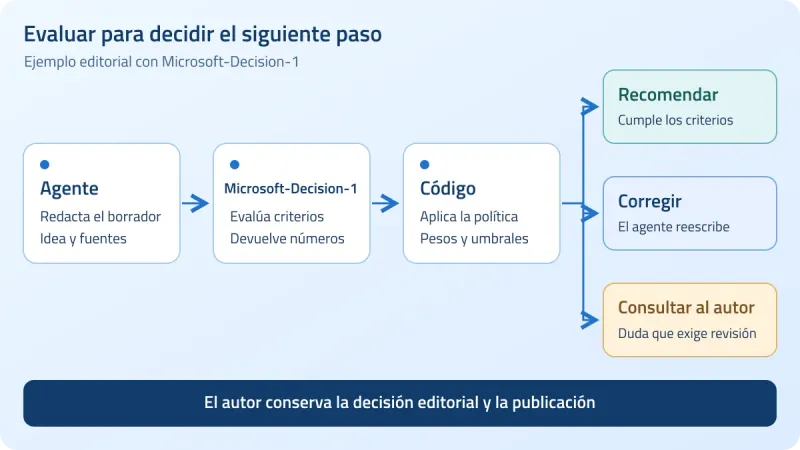
La recomendación de contenido tampoco publica el artículo. Esa sigue siendo otra decisión del proceso.
Este reparto da continuidad a lo que expliqué en No todo necesita agentes de IA: si la condición es exacta, la dejo en código. No usaría Microsoft-Decision-1 para comprobar las dimensiones de una imagen o averiguar si el sitio compila. Su lugar está en las comprobaciones que necesitan interpretar significado.
Qué cambia cuando cada decisión cuesta muy poco
Microsoft publica una tarifa de 0,042 USD por millón de tokens de entrada y sin cobro de tokens de salida. El precio está en el anuncio del modelo, consultado el 22 de octubre de 2026.
Si una revisión consume 10.000 tokens entre contenido, contexto e instrucciones, esta sería la cuenta del modelo:
| Revisiones | Tokens de entrada | Coste a esa tarifa |
|---|---|---|
| 1 | 10.000 | 0,00042 USD |
| 1.000 | 10 millones | 0,42 USD |
| 100.000 | 1.000 millones | 42 USD |
Son estimaciones de una carga supuesta, no facturas del blog. Tampoco incluyen otros servicios, reintentos o intervención humana.
La oportunidad aparece cuando dejamos de evaluar solo unos pocos elementos porque cada revisión exige una conversación generativa extensa. Podemos plantearnos revisar cada respuesta de soporte, clasificar cada comentario o priorizar solicitudes a medida que llegan.
Un LLM pequeño también puede resultar económico y devolver JSON. La comparación debe hacerse con la misma tarea y una calidad suficiente. Lo que me interesa de un modelo de decisión es pagar por el juicio que necesita la aplicación, sin generar una explicación que después nadie va a utilizar.
En un blog pequeño, el ahorro absoluto puede ser modesto. En un sistema con miles de comprobaciones diarias, esa elección empieza a afectar qué automatizaciones merece la pena construir. De todos modos, enviar contexto de más sigue costando: una tarifa baja no vuelve necesario todo el material que podríamos adjuntar.
La rapidez se nota cuando hay que esperar varias veces
Microsoft informa de una latencia mediana aproximadamente 35 veces menor que la de GPT-6 Sol en sus pruebas de decisiones estructuradas. Es una comparación del proveedor para esas condiciones, no una medición nuestra ni una promesa sobre cualquier aplicación.
Para una revisión ocasional quizá unos segundos no cambien mucho. Pero si una solicitud pasa por clasificación, selección de un flujo y evaluación de una respuesta antes de terminar, cada espera se suma a la experiencia del usuario.
Ahí veo el valor de una decisión rápida. Puede formar parte del recorrido habitual de la aplicación, sin obligar a esperar una explicación extensa en cada paso. Aun así, mediría la llamada completa desde el servicio que la consume: la red, el tamaño del contexto y la concurrencia también cuentan.
La misma clase de uso ya tiene un ejemplo documentado por Microsoft: XBOX Research clasificó más de 10.000 comentarios y reseñas en temas definidos por investigadores. La utilidad estaba en ordenar el material para analizarlo, no en escribir una respuesta para cada comentario. Es una prueba interna descrita en el anuncio, no una experiencia de este blog.
Dónde encaja frente a otras alternativas
Yo elegiría la herramienta según el tipo de pregunta:
| Necesidad | Opción que evaluaría primero |
|---|---|
| Comprobar permisos, formatos o rangos exactos | Código y validadores deterministas |
| Clasificar un dominio estable con suficientes ejemplos propios | Un clasificador especializado |
| Interpretar texto y elegir entre opciones delimitadas | Un modelo de decisión como Microsoft-Decision-1 |
| Redactar, explicar o resolver un problema abierto | Un LLM generativo |
Frente a otros modelos de decisión, la razón práctica para probar Microsoft-Decision-1 sería su encaje en Foundry. Para un equipo que ya trabaja en Azure, permite integrar esa capacidad en ese entorno, con autenticación mediante Microsoft Entra ID. Después tocaría comprobar las preguntas con datos propios: estar en el mismo ecosistema facilita la integración, pero no decide la calidad por nosotros.
Antes de incorporarlo empezaría por una comprobación fácil de revisar, como la contradicción entre fuente y borrador. Reuniría ejemplos correctos, incorrectos y dudosos, y observaría tanto los errores como los casos que devuelve al autor. Una salida bien formada también puede contener una decisión equivocada.
La oportunidad está en construir aplicaciones donde la IA ayuda a elegir qué ocurre después. Revisar un borrador, ordenar una cola o filtrar una respuesta son funciones útiles aunque no produzcan contenido nuevo. Microsoft-Decision-1 ofrece una pieza para ese trabajo; definir bien las opciones y decidir qué errores podemos tolerar sigue siendo responsabilidad de quien diseña la aplicación.