Kafka y .NET: por qué es el estándar de los eventos y cómo sacarle provecho
Este artículo forma parte del pilar .NET y arquitectura.
Kafka aparece en casi toda conversación de arquitectura de eventos. A veces con motivo; otras porque a alguien le sonó bien en una reunión. Y ahí está el primer problema: la mayoría de los equipos lo evalúa como si fuera una cola de mensajes rápida, y con esa lectura termina usándolo mal o descartándolo sin entenderlo.
Mi postura es simple: Kafka no es una cola con esteroides. Es un log distribuido donde los mensajes no se borran al consumirse. Esa diferencia explica por qué domina el streaming de eventos desde hace años, define las reglas de su modelo y marca cómo sacar provecho real desde .NET con poco código.
Kafka no es una cola, es un log
En una cola tradicional, cuando un consumidor confirma un mensaje, este desaparece. En Kafka, el mensaje se escribe en un log inmutable y permanece según la política de retención: horas, días o para siempre. Consumir no es quitar; es mover un puntero.
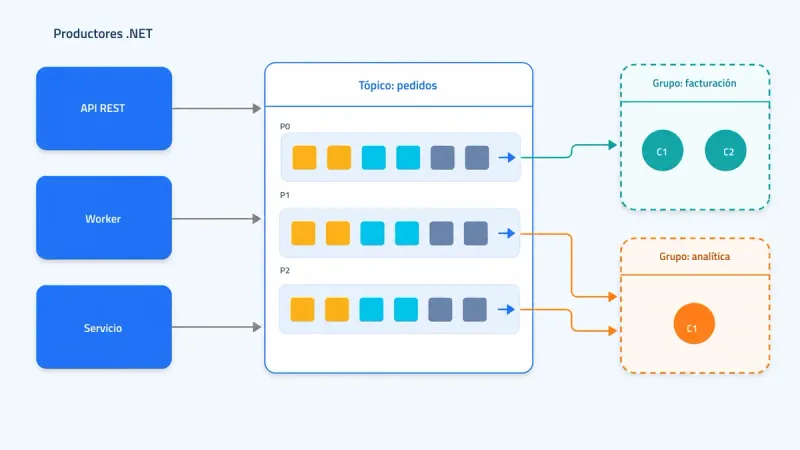
Ese puntero es el offset: la posición de un mensaje dentro de una partición. Un tópico se divide en particiones, cada una es un log ordenado e independiente, y un grupo de consumo reparte esas particiones entre sus consumidores: una partición se la lleva un solo consumidor del grupo a la vez.
De ese modelo salen las dos consecuencias que definen todo lo demás:
- La partición es la unidad de orden y de paralelismo. Dentro de una partición hay orden garantizado; entre particiones, no. Si necesitas orden por cliente, la clave de partición debe ser el cliente. Y el paralelismo máximo de un grupo es el número de particiones: con tres particiones, un cuarto consumidor del mismo grupo se queda de brazos cruzados.
- El replay es gratis. Como nada desaparece, un consumidor nuevo, un bug corregido o una vista a reconstruir pueden rebobinar el offset y reprocesar. Con una cola, lo consumido se fue para siempre. Si alguna vez rompiste un proceso a las 3 a.m. y necesitabas lo perdido, sabes cuánto vale esto.
Cambiar de mentalidad —de cola a log— es el 80% de la curva de aprendizaje de Kafka. El resto es API.
Por qué se usa tanto
No es moda ni marketing. Son propiedades concretas que resuelven problemas reales:
- Rendimiento. Escrituras secuenciales a disco, agrupación de mensajes en lotes y envíos por bloques del lado del cliente sostienen cientos de miles de eventos por segundo en hardware modesto. En un clúster bien dimensionado, los millones no son exóticos.
- Desacoplamiento temporal. El productor no espera a nadie. El consumidor puede estar caído, desplegando o en mantenimiento: los eventos quedan en el log y se procesan cuando vuelva. Sin perder nada.
- Fan-out natural. Varios grupos de consumo leen el mismo flujo con offsets independientes. Un mismo evento alimenta facturación, analítica y notificaciones sin duplicar publicaciones ni acoplarse entre sí.
- Reprocesabilidad. Replay, auditoría, event sourcing, reconstruir proyecciones. El log es la fuente de verdad y las vistas son derivadas.
- Ecosistema. Kafka Connect para integrar bases de datos y sistemas externos, procesamiento con Kafka Streams o Flink, y Schema Registry para versionar contratos.
Un punto de operación que antes frenaba adopciones: desde Kafka 4.0 ya no existe ZooKeeper; el clúster se coordina solo con KRaft. Levantar un clúster de desarrollo es hoy un contenedor, no un zoo.
Visto fríamente, Kafka gana porque convierte un problema de integración punto a punto —donde cada conexión nueva es una condición más que puede fallar— en un problema de escribir y leer un log. El costo de agregar un servicio al ecosistema deja de crecer con cada par de sistemas que se hablan.
Cómo lo aprovecha .NET
El cliente de referencia en .NET es Confluent.Kafka, un binding maduro sobre librdkafka que corre en Linux, Windows y macOS. Y aquí hay una coincidencia afortunada: el modelo de Kafka mapea directo a lo que la plataforma ya tiene.
El productor cabe en pocas líneas:
using Confluent.Kafka;
var config = new ProducerConfig{    BootstrapServers = "localhost:9092",    EnableIdempotence = true};
using var producer = new ProducerBuilder<string, string>(config).Build();
await producer.ProduceAsync("pedidos", new Message<string, string>{    Key = pedido.ClienteId,    Value = JsonSerializer.Serialize(pedido)});
EnableIdempotence = true evita duplicados cuando el cliente reintenta tras un timeout. Y fíjense en la Key: es lo que decide la partición. Mismo cliente, misma partición, mismo orden.
El consumidor es un bucle, y el sitio natural en ASP.NET Core o en un Worker Service es un BackgroundService:
public class FacturacionConsumer : BackgroundService{    private readonly IConsumer<string, string> _consumer;    private readonly IServiceProvider _services;
    public FacturacionConsumer(IServiceProvider services)    {        _services = services;        _consumer = new ConsumerBuilder<string, string>(new ConsumerConfig        {            BootstrapServers = "localhost:9092",            GroupId = "facturacion",            AutoOffsetReset = AutoOffsetReset.Earliest,            EnableAutoOffsetStore = false        }).Build();
        _consumer.Subscribe("pedidos");    }
    protected override async Task ExecuteAsync(CancellationToken stoppingToken)    {        while (!stoppingToken.IsCancellationRequested)        {            var result = _consumer.Consume(stoppingToken);            var pedido = JsonSerializer.Deserialize<PedidoCreado>(result.Message.Value);
            using var scope = _services.CreateScope();            await ProcesarPedido(pedido!, scope.ServiceProvider, stoppingToken);
_consumer.StoreOffset(result); } }}NOTA: el código omite manejo de errores, logging y configuración; es de referencia, no para copiar a producción tal cual.
El detalle que importa está en el par EnableAutoOffsetStore = false y StoreOffset después de procesar: el offset solo avanza cuando el mensaje ya se procesó. Eso da semántica at-least-once: si el proceso muere a mitad, otro consumidor retoma desde el último offset confirmado. Con el auto-commit por defecto puedes perder mensajes: la aplicación muere después del commit y antes de procesar.
Para JSON con esquema versionado, el paquete Confluent.SchemaRegistry.Serdes.Json integra con Schema Registry; en producción, Avro o Protobuf son la opción habitual.
Para desarrollo, el propio proyecto publica una imagen que levanta un nodo en modo KRaft con un solo comando:
docker run -d --name kafka -p 9092:9092 apache/kafka:4.3.1Las reglas del modelo que te ahorran dolores
Kafka no es difícil; es estricto. El lenguaje del modelo impone reglas, y respetarlas desde el primer día ahorra semanas:
- El consumidor debe ser idempotente. At-least-once significa que los duplicados no son un bug, son parte de la garantía. Deduplica por identificador de negocio o haz que el efecto sea repetible.
- Diseña la clave de partición antes de escribir el productor. Cambiar el particionado con datos ya en el log redistribuye mensajes entre particiones y rompe el orden por clave.
- Dimensiona las particiones al inicio. Son tu techo de paralelismo por grupo, y añadirlas después sobre un tópico con claves es una operación que no perdona.
- Gestiona los rebalances. Cuando un consumidor entra o sale del grupo, las particiones se reasignan. Registra un
SetPartitionsRevokedHandlerpara confirmar offsets pendientes en el corte. - Versiona los contratos. En un log duradero, los mensajes viejos conviven con los nuevos durante meses. Schema Registry con Avro o Protobuf evita que un cambio de campo rompa a los consumidores a medianoche.
- No pidas consultas al log. Kafka no es una base de datos consultable. Si necesitas consultar estado, construye una proyección: el consumidor materializa su vista en su propio almacén.
Cuándo sí y cuándo no
Lo usaría cuando hay varios servicios integrados por eventos, volumen serio de mensajes, necesidad de replay o auditoría, pipelines de streaming o event sourcing. También cuando el desacoplamiento temporal es el requisito dominante: sistemas que deben seguir funcionando aunque una pieza esté caída.
No lo haría la primera opción cuando:
- El volumen es bajo y solo hay un productor y un consumidor: RabbitMQ o Azure Service Bus resuelven con menos operación.
- Lo que necesitas es una cola de trabajo con confirmación por mensaje: ahí las colas tradicionales son más directas. Para trabajos en segundo plano dentro de una sola aplicación .NET, ni siquiera hace falta un broker.
- Es un equipo pequeño sin experiencia operando clústeres: el costo de operación —discos, monitoreo, rebalances, capacidad— es real y no desaparece por ser open source.
En el mundo Azure hay un punto medio pragmático: Event Hubs habla el protocolo de Kafka, así que el mismo código de Confluent.Kafka apunta a un servicio gestionado sin montar clúster. Y Confluent Cloud hace lo mismo como servicio dedicado.
La pregunta que haría antes de instalar nada: ¿necesitas que los eventos sobrevivan a los consumidores? Si la respuesta es sí, Kafka —o su variante gestionada— es la herramienta. Si es no, probablemente necesitas una cola, y cargar con Kafka solo te trae la factura sin el beneficio.
Si quieres seguir aprendiendo sobre estos temas, te invito a ver mis otras publicaciones.
Referencias
- Documentación de Apache Kafka
- .NET Client for Apache Kafka (Confluent)
- Descargas y versiones de Apache Kafka